用 PathoWish 建立有独立测试集的生存预后项目
228例患者固定拆分、训练集拟合与69例独立测试,原创Cox模型输出风险、生存曲线和校准图,测试C-index为0.644。
从一张包含随访时间和事件状态的临床表开始,PathoWish 可以把参考文献转为可复现的预后分析项目。本例使用公开 NCCTG 肺癌数据的 228 例患者,固定拆分为 159 例训练、69 例测试,原创实现 Cox 比例风险模型,导出风险、个体生存概率和图表报告。独立测试集的 Harrell C-index 为 0.644。
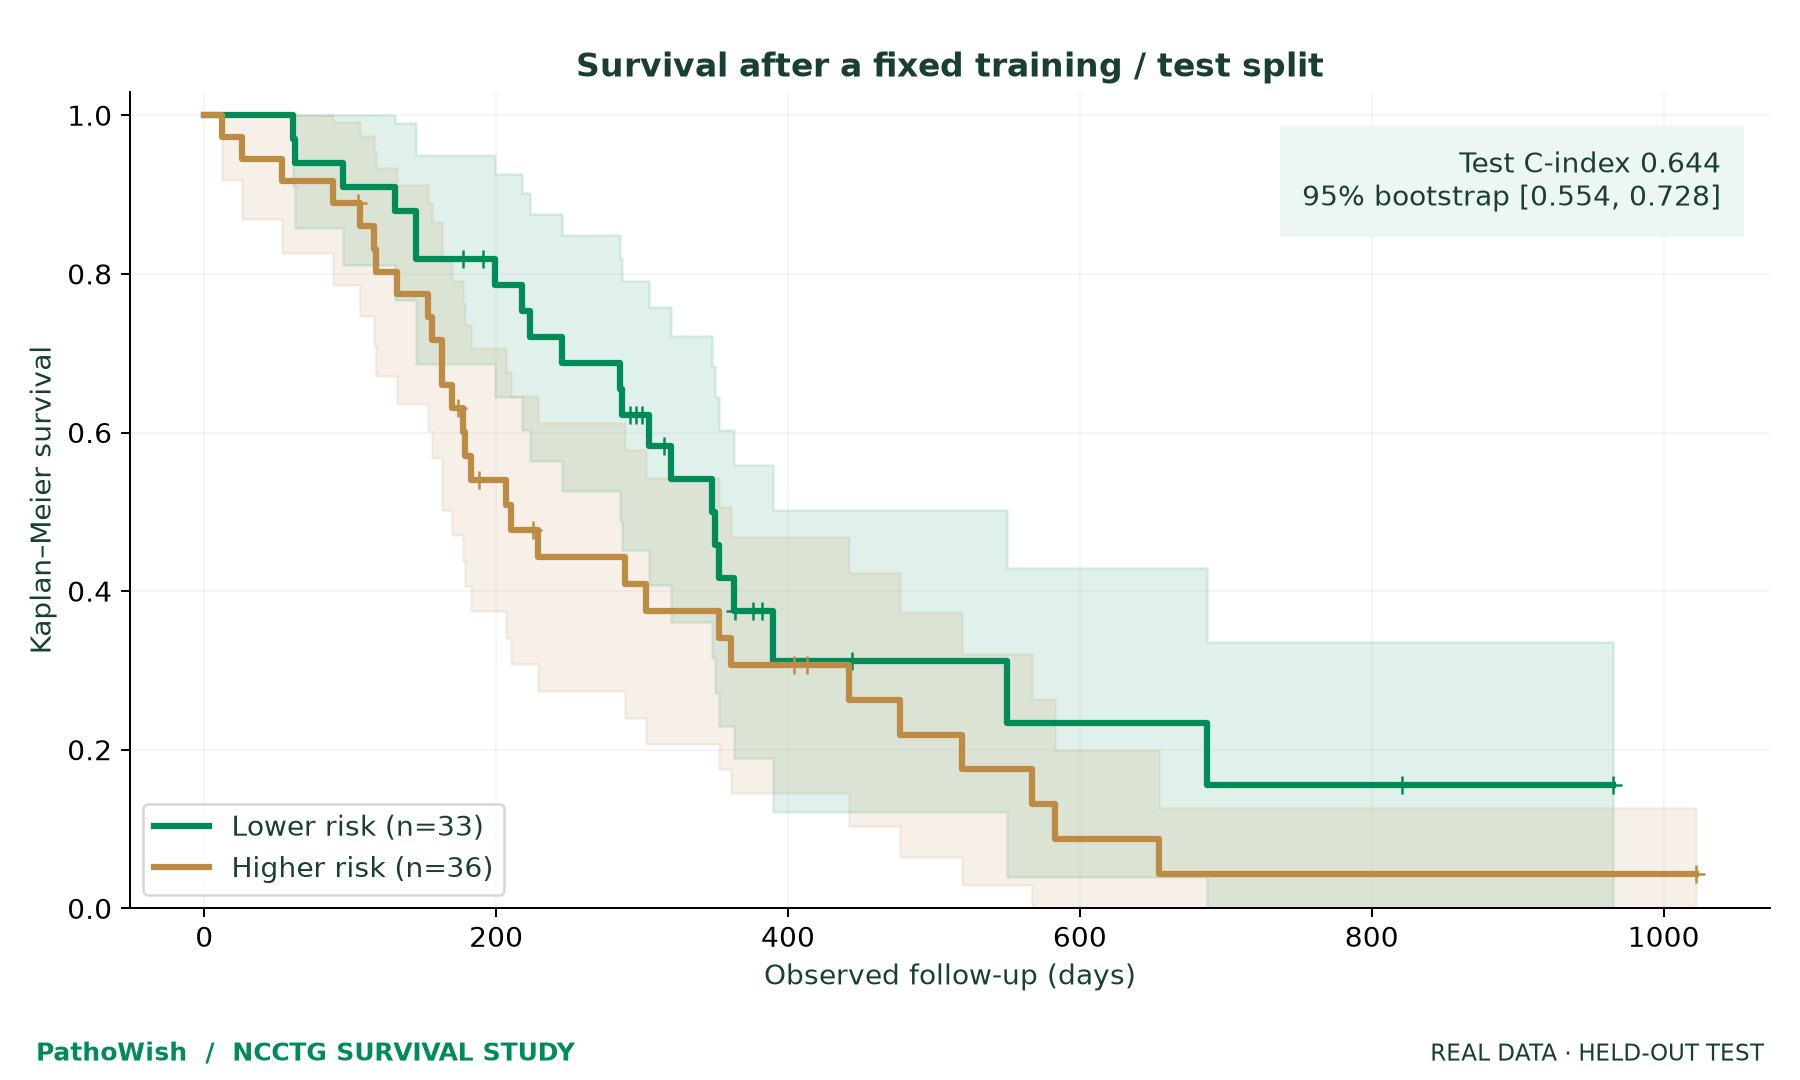
两组由训练集风险中位数划分;曲线只使用测试患者的真实随访和事件。风险分组阈值在测试评价前已确定。
1. 准备随访表和参考文献
数据来自 R survival 包的 NCCTG 肺癌示例,字段定义见 维护者的 lung 文档。复现包内下载脚本从 Rdatasets 的 survival/cancer.csv 读取 CSV,保存为 data/lung.csv 并校验固定 SHA256。本次还用 lifelines 提供的同一队列 CSV 核对,显式统一事件编码后,228 行、10 个原始字段全部一致。
| 字段 | 本例含义与处理 |
|---|---|
| time | 随访时间,单位为天 |
| status | 原始编码 1=删失、2=死亡;程序转换为 event=0/1 |
| age | 年龄,连续变量 |
| sex | 原始 1=男性、2=女性;模型使用 female 指示变量 |
| ph.ecog | ECOG 体能状态,按有序数值进入模型;一例缺失由训练集中位数填补 |
研究设计为该公开队列的内部独立留出评价:患者级固定拆分,训练阶段决定填补、标准化、模型、基线风险和分组阈值。模型采用比例风险和对数风险线性效应条件;区间通过固定模型的测试患者重采样获得,反映这次测试样本的不确定性。
参考 *Tutorial on survival modeling with applications to omics data* 的模型和验证章节。知识库中没有该文时,从 官方开放全文页下载 PDF,在阶段2“参考文献与自备材料”点击“+ 添加 PDF 文献”,选择文件并核对标题和勾选状态。
2. 在插件中绑定数据和环境
打开“数据与范围”,点击“+ 增加数据”,选择只包含 lung.csv 的示例数据目录,并说明这是包含随访时间、事件与协变量的患者级表。
选择已有 Python 环境,使用 NumPy、SciPy、pandas、scikit-learn 和 Matplotlib。本例在 CPU 上执行,保持现有环境不安装或升级依赖。
在“建模项目”提交:
用所选 NCCTG 肺癌数据建立可复现的生存预后项目。time 为天,status 为 1 删失、2 死亡。按事件分层、固定种子 20261015,划分约 70% 训练、30% 测试。只用训练集拟合缺失填补、标准化、Cox 模型与风险分组阈值。变量使用 age、sex、ph.ecog,Breslow 处理并列事件时间。输出独立测试 C-index、固定模型测试患者 bootstrap 区间、患者风险表、KM 曲线、个体预测生存曲线和校准图;保留拆分、模型、核验记录和 PathoWish 品牌报告。
3. 确认分析方案
阶段1“调研文献与资源”读取模型原理和验证方法;阶段2“确认方案与仓库”核对变量、事件编码、拆分、评价和环境。
本例借鉴论文的低维生存建模、风险排序和图形验证思想,针对三项临床变量从头实现项目。Cox 部分似然、解析梯度、Breslow 基线累积风险和生存概率计算均放在项目源码中;通用库用于优化、拆分、数组和绘图。
确认后勾选“我已核对方案与所选仓库,确认按以上方案开发”,点击“确认方案并开始定制开发”。阶段3“分析源码与定制开发”显示代码生成,阶段4“验证并查看结果”显示运行和模型评审。
4. 查看真实的数据流
| 步骤 | 训练数据参与 | 测试数据参与 | 保存的证据 |
|---|---|---|---|
| 固定患者拆分 | 159 例,115 个事件 | 69 例,50 个事件 | split.csv |
| 缺失填补与标准化 | 估计中位数、均值和标准差 | 仅应用已保存参数 | preprocessing.json |
| 模型拟合 | 最大化 Cox 部分似然,Breslow 处理并列时间 | 不参与拟合 | model.json、coefficients.csv |
| 风险与生存预测 | 估计基线风险与分组阈值 | 生成每例风险及生存概率 | predictions.csv、test_survival_predictions.csv |
| 独立评价 | 不用于测试指标 | C-index、KM、校准、1000 次重采样 | metrics.json、test_km.csv、bootstrap_cindex.csv |
风险分数为标准化变量的线性组合。训练集风险中位数为 0.0279463,据此将测试患者分为低风险 33 例、高风险 36 例。整个过程没有根据测试结果重选拆分或调参。
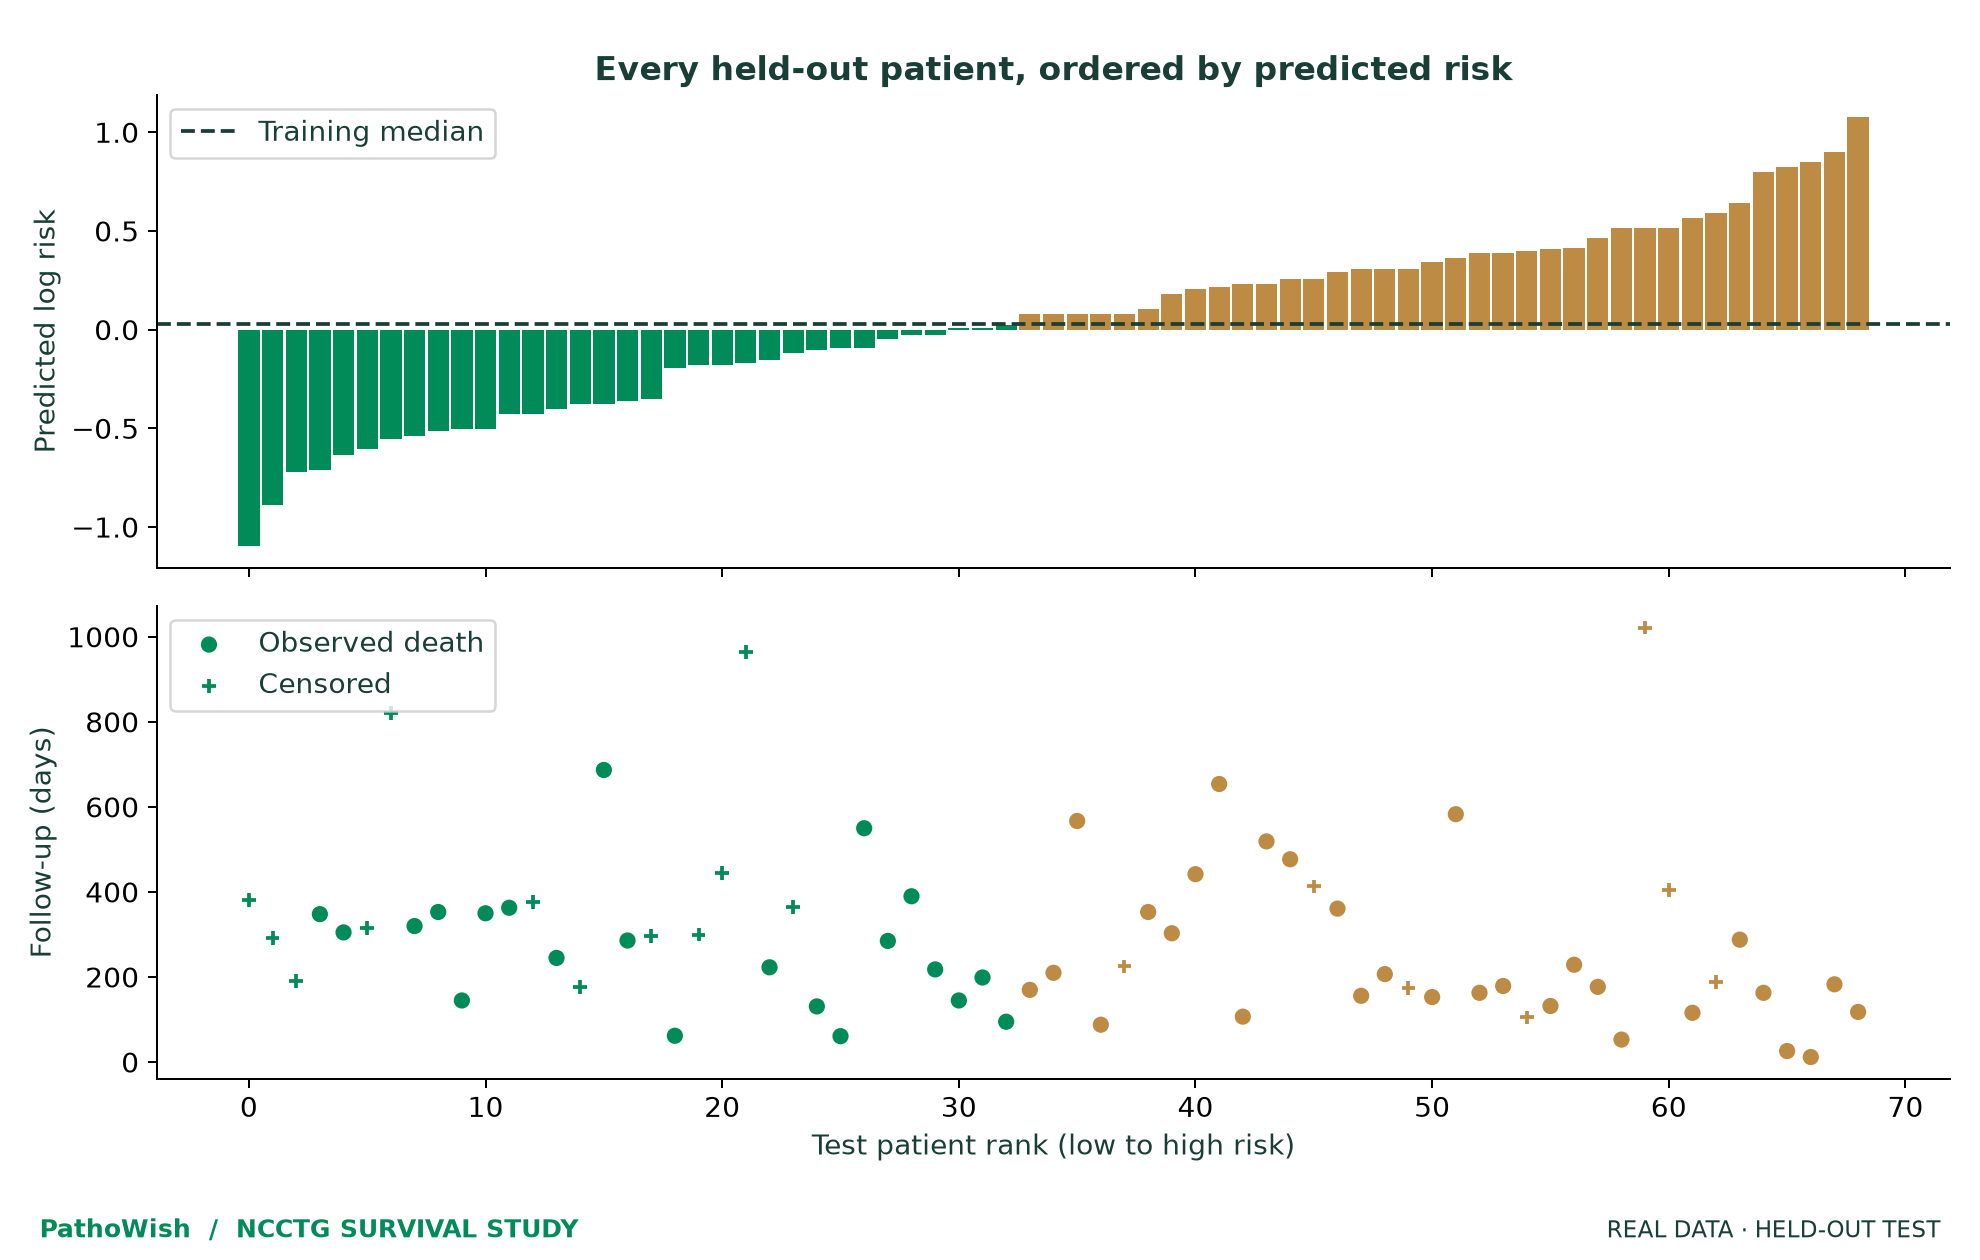
图中风险来自模型预测,随访时间和删失状态来自真实测试表。风险与个体结局之间存在重叠,因此同时查看排序指标和生存概率表现。
5. 解读独立测试指标与校准
| 项目 | 实际结果 |
|---|---|
| 测试患者数 | 69 |
| 测试事件 / 删失数 | 50 / 19 |
| 严格时间可比较对 | 1868 |
| Harrell C-index | 0.643737 |
| 固定模型测试患者 bootstrap 次数 | 1000 |
| 95% 百分位区间 | 0.553529–0.727868 |
C-index 使用严格不同时间的可比较对:较早发生事件者风险更高记为一致,预测风险相同记半分;相同随访时间的成对样本不计入。核验程序用另一段逐对循环独立重算,结果一致。
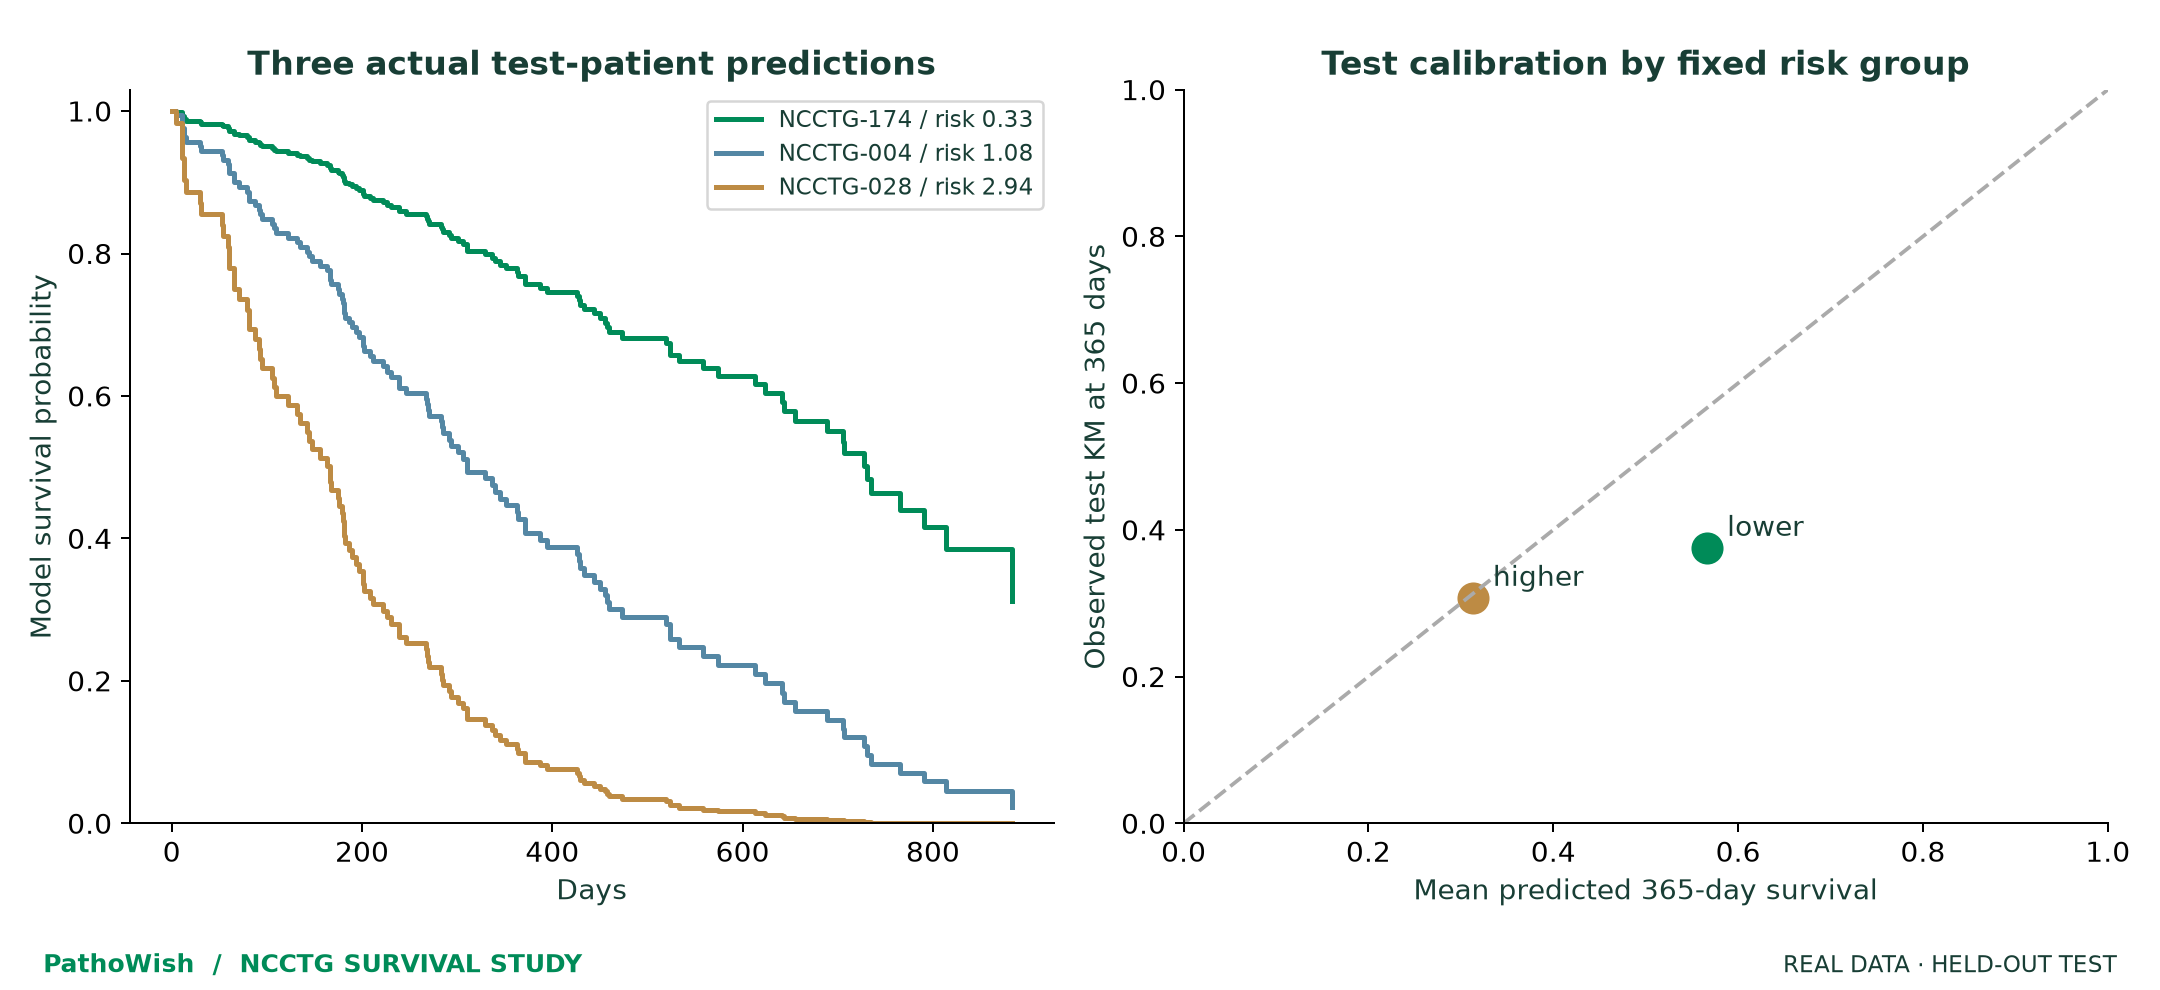
生存概率通过训练集基线累积风险与患者预测风险计算。365 天时,低风险组平均预测生存概率为 0.5664,实际 KM 估计为 0.3748;高风险组分别为 0.3130 和 0.3067。这提示低风险组存在生存概率高估,后续可据此设计更大的验证研究和校准方案。
完整 test_survival_predictions.csv 保存 69 例测试患者在基线事件时间网格上的预测生存概率,可直接用于后续曲线绘制和复核。
6. 核对诊断与自动修正
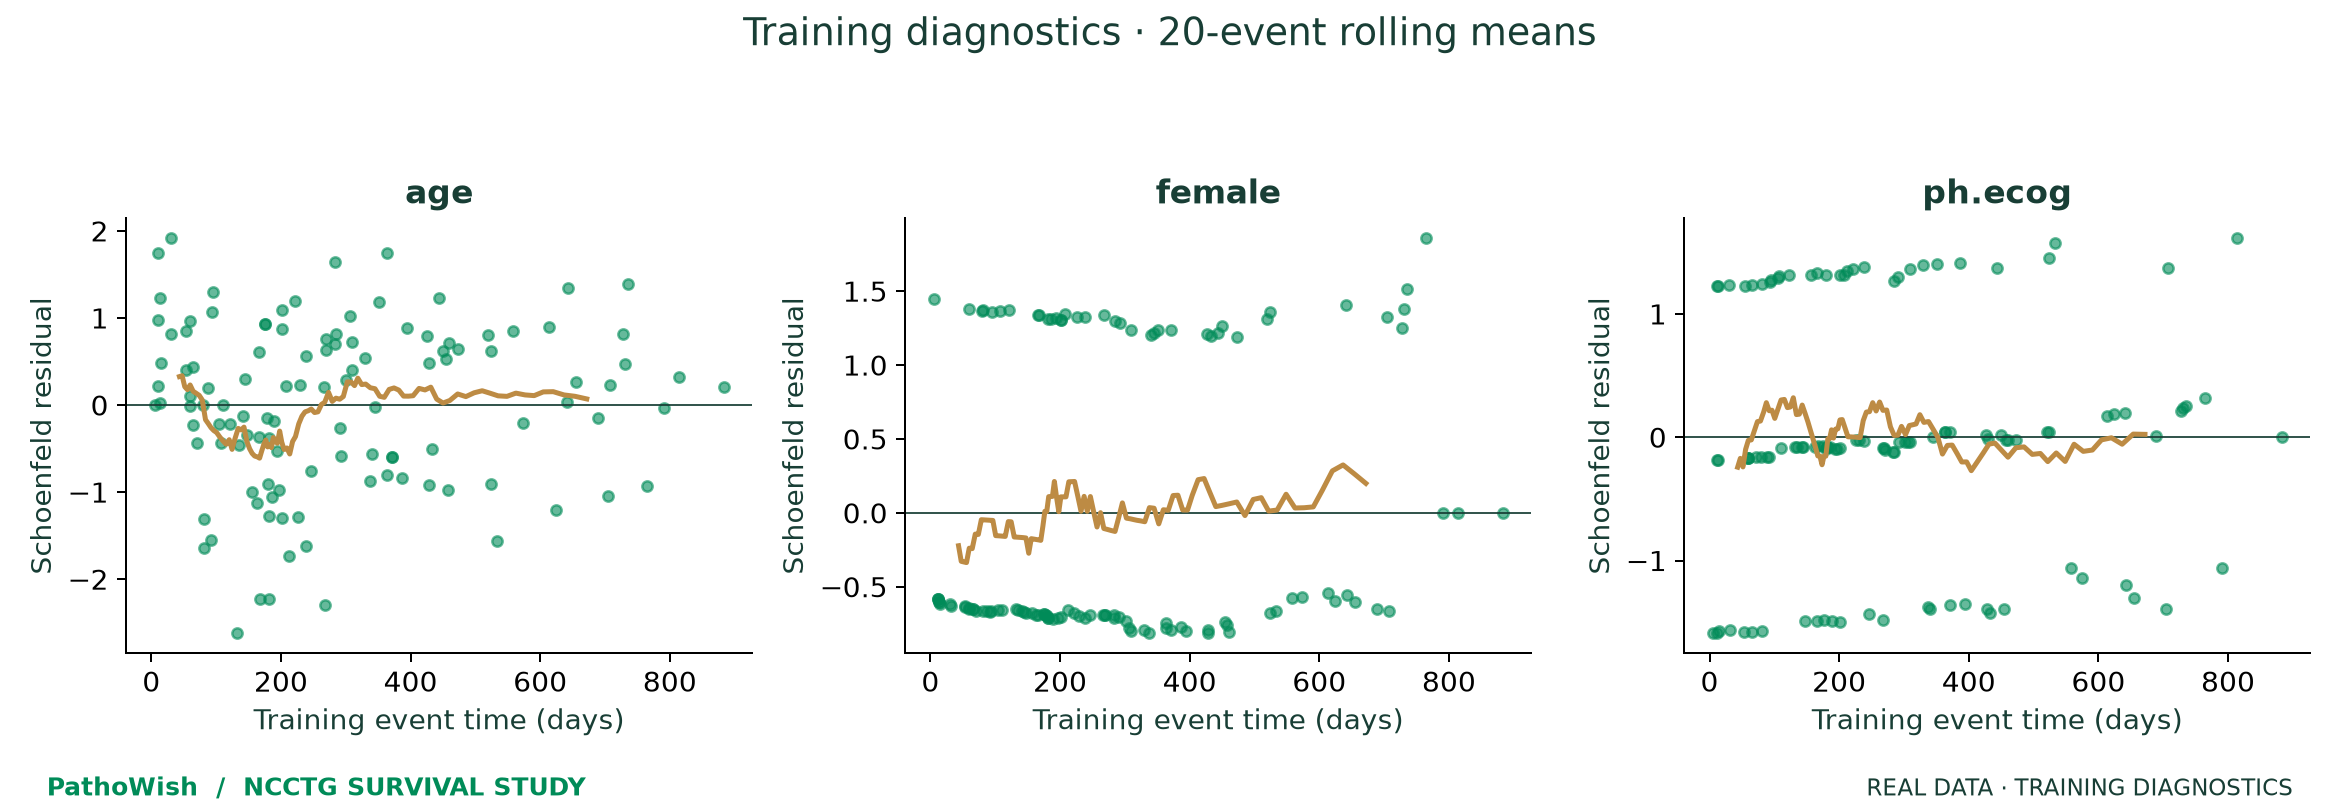
训练残差图用于观察随时间变化的趋势;优化检查核对解析梯度与有限差分。最终 BFGS 经过 8 轮迭代成功收敛,最大梯度约为 4.17e-7,有限差分梯度最大误差约为 1.54e-8。
首轮已产出全部科学结果,模型阅读优化回执与图表后,将过严的优化停止容差从 1e-7 调整为 1e-6,修正诊断图标题布局,并补充完整测试患者生存曲线 CSV。插件创建新子版本执行;新旧 metrics.json 完全相同,父版 32 个登记产物的 SHA256 保持不变。
最终五步全部完成,25 项核验通过,包括患者拆分、训练集预处理、解析梯度、独立 C-index、训练基线风险、KM 乘积、生存概率范围与单调性、完整患者曲线导出及图像文件检查。
7. 打开报告和项目代码
进入“结果与图表”,查看四张图和完整指标。点击“打开结果文件夹”读取 CSV、模型、数组与核验记录;使用项目代码仓库入口打开 prepare.py、survival_math.py、fit.py、evaluate.py 等原创模块,继续加入自己的变量和验证设计。
汇总报告包含真实结果、执行状态、技术选择和 PathoWish 品牌元素,可打印为 PDF。更换数据时,先核对患者标识、时间起点、事件定义、单位及拆分策略,再创建新的项目版本。
复现包保留原始代码、固定下载哈希、参考产物和执行入口。在具有项目依赖的环境中运行:
python DOWNLOAD_DATA.py
python REPRODUCE.py
输出写入 artifacts/versions/,可与 reference-results/ 对照。包内同时提供固定输入哈希、方法说明和参考结果。
执行与来源记录
最终版本 version-39773373e71d,最终运行 run-9d4af0c59e。通过真实 Projects / NativeAPI / HostAssistant 链,由当前会话模型逐轮读取文献、编写代码、运行评审并创建修正版。UI 步骤提供给使用者复现;本次开放全文通过隔离驱动预置,验收层级为源码后端执行链。
- Tutorial on survival modeling with applications to omics data,2024,开放全文。
- survival 包 lung 数据定义与 原始 cancer.rda。队列文献为 Loprinzi et al., *Prospective evaluation of prognostic variables from patient-completed questionnaires*, Journal of Clinical Oncology, 1994。
- Rdatasets CSV与 lifelines 同队列 CSV,用于格式交叉核对;字段编码转换保留于来源记录。