把细胞核分成独立实例与类别:NuCLS 小样本实操
从官方轮廓和类别标签训练核前景与对象分类器,核对逐核表、实例匹配和三类表现。
这次从公开H&E图像和人工QC核标注出发,完成“核前景学习 → 独立实例 → 三类预测 → 留出核验”。结果包括逐核ID、类别、面积与质心表,实例轮廓叠加图,以及训练和评价记录。
1. 准备图像与真实核标签
下载最小复现包(约14 MB)。inputs包含NuCLS官方corrected single-rater QC数据中的9张PNG、9份CSV和固定划分 split.json。数据来自NuCLS官方页面,数据许可为CC0 1.0;完整来源、哈希和标签说明在包内。
在插件“数据与范围”选本地执行、新建工作目录,并通过“+ 增加数据”绑定解压后的 inputs文件夹。检查CSV与图像同名对应,保留 split.json。
| 数据划分 | 患者 | 视野 | 本次可用三类真实轮廓 |
|---|---|---|---|
| 训练 | TCGA-A1-A0SP、TCGA-A2-A0CM | 6 | 90 |
| 留出 | TCGA-A2-A0D0 | 3 | 72 |
训练轮廓为11个肿瘤核、17个间质核、62个淋巴细胞核。类别读取CSV的 main_classification:tumor_nonMitotic/tumor_mitotic合为肿瘤,nonTILnonMQ_stromal为间质,lymphocyte为淋巴。只有 polyline作为像素轮廓;矩形、点和其他类别保留在原始输入中,并记录被排除的数量。
2. 提交可执行的项目需求
选择兼容的Python 3.12环境。本次使用NumPy 2.2.6、SciPy 1.15.3、scikit-image 0.25.2、scikit-learn 1.6.1、Pandas 2.2.3、Matplotlib 3.10.3、Pillow 11.2.1、joblib 1.6.0,无需下载预训练模型。
点击“提交建模需求”,粘贴:
使用已绑定的NuCLS QC图像和CSV,按split.json固定患者划分,独立实现细胞核实例分割与肿瘤、间质、淋巴三分类。只用polyline作轮廓真值,按main_classification映射类别;矩形及点区域不作为背景负例。采用监督多尺度前景特征、距离分水岭和对象分类器,保存模型、实例ID图、逐核CSV、彩色轮廓及匹配评价。冲突轮廓像素排除并计数。冻结参数后处理留出患者,生成带PathoWish元素的报告。
在需求核对页确认输入范围与运行环境后提交。
3. 核对文献依据与开发方案
阶段1阅读NuCLS开放全文,重点看混合标注、QC类别和轮廓评价。需要补充PDF时,在阶段2“参考文献与自备材料”添加论文。
这里复用数据语义和评价思路,自己实现三个模块:30维多尺度颜色特征学习核前景;距离峰与分水岭生成实例;18维形态和H&E颜色统计学习三类对象。前景模型64棵ExtraTrees,对象模型128棵,随机种子20261015。分水岭前景阈值0.5、最小面积16像素、峰间距6像素,均在测试前固定。
在阶段2确认方案后,观察阶段3与阶段4的持续进度。本次模型评审遇到两处真实实现问题:轮廓栅格化有交叠,以及程序误把原始类别字段当作归并字段。它分别创建子版本,排除冲突像素、改读 main_classification,然后重新执行;原始失败记录和固定患者划分均保留。
4. 一起看实例与类别结果
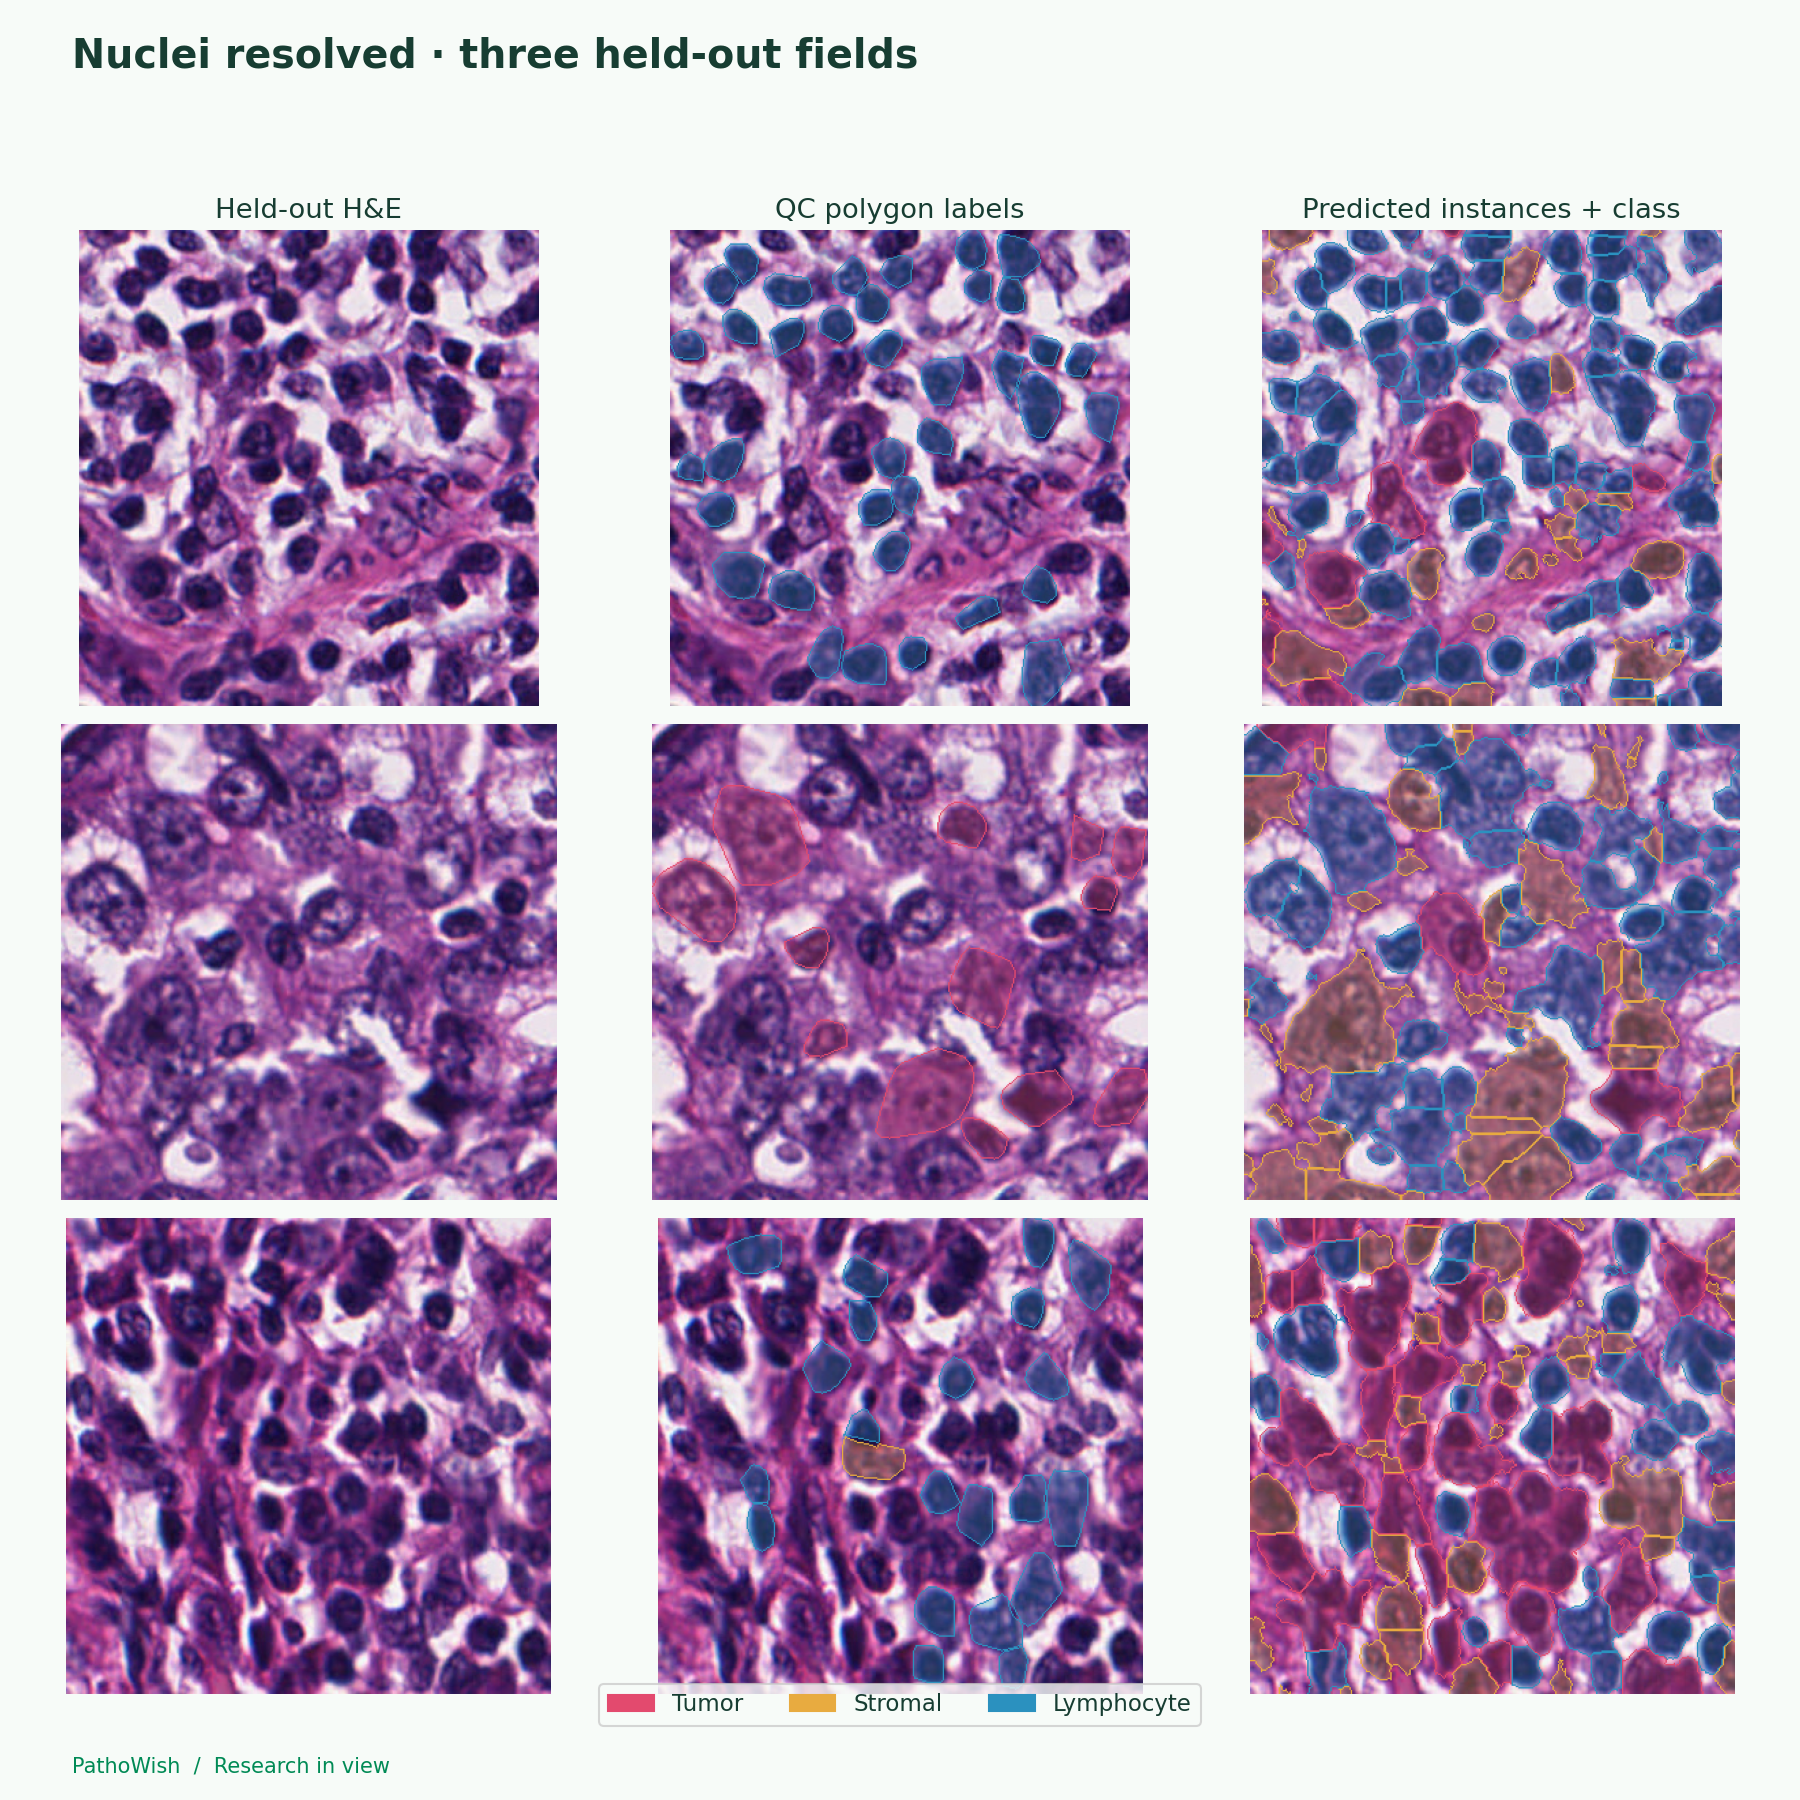
三个留出视野输出313个预测实例;其中72个具有本次所用三类真实轮廓的核参与匹配。用一对一IoU匹配并要求IoU≥0.5,61个真值核成功匹配,匹配召回为84.72%;61个匹配核中44个类别正确,匹配类别准确率72.13%。
| 类别 | 真值轮廓 | 匹配实例 | 匹配召回 | 匹配核类别正确 |
|---|---|---|---|---|
| 肿瘤 | 13 | 11 | 84.62% | 1/11(9.09%) |
| 间质 | 1 | 1 | 100% | 0/1(0%) |
| 淋巴细胞 | 58 | 49 | 84.48% | 43/49(87.76%) |
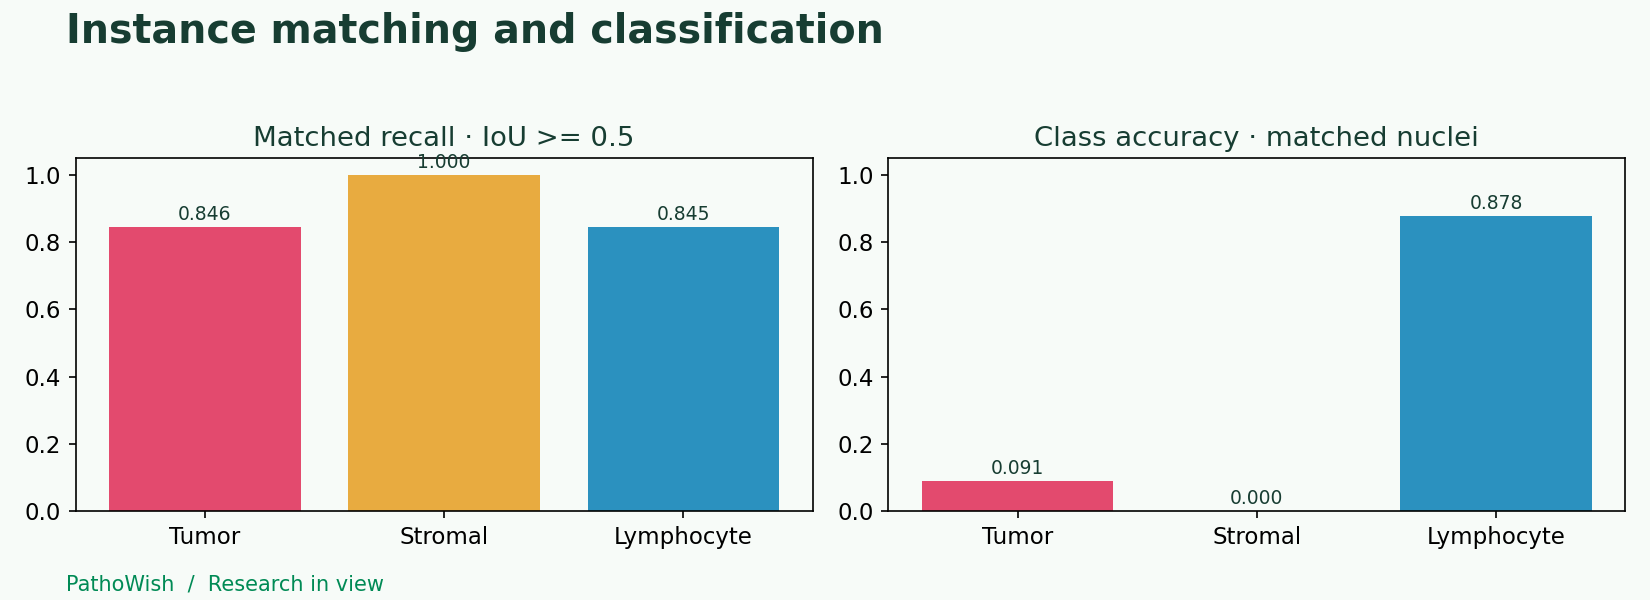
第一张对照图里,大量核能被分开,但第二行肿瘤视野的类别预测明显不理想。整体数值受淋巴细胞占比较高影响,应把逐类表和原图一起看。后续改进可增加独立患者的肿瘤、间质训练轮廓,并另设验证集;本次保留原始留出结果。
5. 找到对象表、报告与代码
在“结果与图表”打开本次报告,点击“打开结果文件夹”,查看 nuclei.csv、matches.csv、predictions.npz和PNG。CSV每一行都有视野、实例ID、类别、像素面积与质心,可按ID回到实例图核对。使用“打开项目代码”继续修改特征、分类器或分水岭模块。
下载包的 python run_case.py只核对输入,python run_case.py --run会重跑已公开的固定代码。新结果进入 project/artifacts/versions,原始 results作为参考保留;模型文件 nuclei-models.joblib的来源和SHA在 model-manifest.json。
方法与核验记录
训练按患者分开,像素抽样仅来自训练视野。背景负例取真实轮廓附近、所有已标注框之外的区域。轮廓交叠像素从实例及监督范围中排除并计数;留出三视野分别排除4、0、79个冲突像素,没有实例因此完全消失。前景Dice在真实轮廓及邻近有效背景内计算,三个视野分别为0.9447、0.9277、0.9222。因为QC是轮廓与框混合标注,313个全视野预测不能直接作为全图检测精确率的分母。
独立核验将313个实例的ID、类别、面积与质心逐一和数组比较,并复算72个评价行、61个匹配及44个正确类别。所有输入哈希不变。本例保留了当前模型评审与子版本修复链。本次测试通过插件的项目后端执行;以上界面步骤供用户复现。
来源:Amgad等,*NuCLS: A scalable crowdsourcing approach and dataset for nucleus classification and segmentation in breast cancer*. GigaScience, 2022, giac037。原始数据使用CC0 1.0,包内保留官方来源和固定子集。当前两个模型均由本次代码训练。