双组学整合:分析 Nutrimouse 基因与脂质数据
对齐 40 只小鼠的 120 个基因与 21 种脂质,完成双块潜变量分析,查看投影、载荷、关联热图和完整项目代码。
这篇教程用同一批小鼠的基因表达与脂质数据,带你在 PathoWish 中完成样本对齐、标准化、双块潜变量整合和结果解释。项目会生成样本投影、主要载荷、关联热图、完整数据表与实验报告。
本例包含 40 只小鼠、120 个基因和 21 种脂质。三步计算完成后,两对组学得分的相关系数为 0.655153 和 0.686738,8 项数值检查通过。
1. 准备样本一一对应的三张表
输入来自 mixOmics 固定提交中的 Nutrimouse 数据对象。原始文件为 7,647 字节,SHA-256 为 3c6212f3f13feb88e3ff8e48c855a284d496cf60ca1b53c7e5913978bf8261fc。
将数据整理为同一目录中的三个 CSV:
| 文件 | 第一列 | 数据列 |
|---|---|---|
gene.csv | sample_id | 120 个基因的连续测量值 |
lipid.csv | sample_id | 21 种脂质的连续测量值 |
metadata.csv | sample_id | diet、genotype 分组 |
三张表保留同一份样本标识。本例使用原始行标识 1–40,分组用于图形标注。
在已有 pandas 和 rdata 的数据准备环境中,可以这样导出:
from pathlib import Path
import pandas as pd
import rdata

dataset = rdata.conversion.convert(
    rdata.parser.parse_file("nutrimouse.rda")
)["nutrimouse"]
gene, lipid = dataset["gene"], dataset["lipid"]
assert gene.shape == (40, 120) and lipid.shape == (40, 21)
assert list(gene.index) == list(lipid.index)
out = Path("nutrimouse_csv")
out.mkdir(exist_ok=True)
for name, frame in [("gene", gene), ("lipid", lipid)]:
    frame.index.name = "sample_id"
    frame.to_csv(out / f"{name}.csv")
pd.DataFrame({
    "sample_id": gene.index.astype(str),
    "diet": list(dataset["diet"]),
    "genotype": list(dataset["genotype"]),
}).to_csv(out / "metadata.csv", index=False)
这一步完成 R 对象到 CSV 的转换;后续分析项目使用 Python 读取 CSV。
2. 在插件中设置数据与需求
- 进入“数据与范围”,选择研究项目和“本地执行”。
- 点击“选择工作目录”,设置代码与结果的保存位置。
- 点击“+ 增加数据”,用途填写“按 sample_id 对应的基因、脂质和分组数据”。
- 数据类型选“数据目录”,点击“选择路径并添加”,选中三张 CSV 所在目录。
- 选择已有环境或为项目准备独立环境。本次计算复用了 Python 3.12.14、NumPy 2.4.3 和 Matplotlib 3.11.0 的 CPU 环境。
点击“提交建模需求”,输入:
请整合我选择的 Nutrimouse 基因、脂质与分组 CSV:按 sample_id 核对样本,检查缺失值和常数特征,标准化两组数据,独立实现双块潜变量分析。请展示样本在两个组学空间中的对应关系、主要载荷和基因—脂质关联热图,保存完整结果表、数学方法与依赖说明,并生成带 PathoWish 品牌的实验报告。方法和成分数请根据数据选择。
点击“下一步:核对需求”,确认三张表的用途、执行位置与环境后提交。
3. 确认文献方法与实施方案
在阶段 1“调研文献与资源”查看阅读结果,在阶段 2“确认方案与仓库”核对方案。
本例参考 Rohart 等人的 mixOmics 论文,提取样本对应、低维投影、变量载荷和跨组学关系展示等方法思想。项目以这些思想为依据,独立实现双块交叉协方差的奇异值分解。
需要添加论文时,从 PLOS 文章页下载 PDF,在阶段 2 的“参考文献与自备材料”点击“+ 添加 PDF 文献”,核对标题与选中状态。
方案应明确三项工作:输入质控与标准化、两成分整合、图表与报告。确认完整结果表和样本匹配规则后,勾选“我已核对方案与所选仓库,确认按以上方案开发”,点击“确认方案并开始定制开发”。
4. 查看实现过程与方法
阶段 3“分析源码与定制开发”显示代码生成,阶段 4“验证并查看结果”显示执行和结果审阅。项目按以下依赖顺序运行:
| 步骤 | 模块 | 主要输出 |
|---|---|---|
| 样本质控与标准化 | data_io.py | 输入检查、尺度表、标准化数据 |
| 双块整合 | integration.py | 得分、载荷、完整相关矩阵、奇异值 |
| 绘图与说明 | figures.py | 四幅图、结果说明与数值核对 |
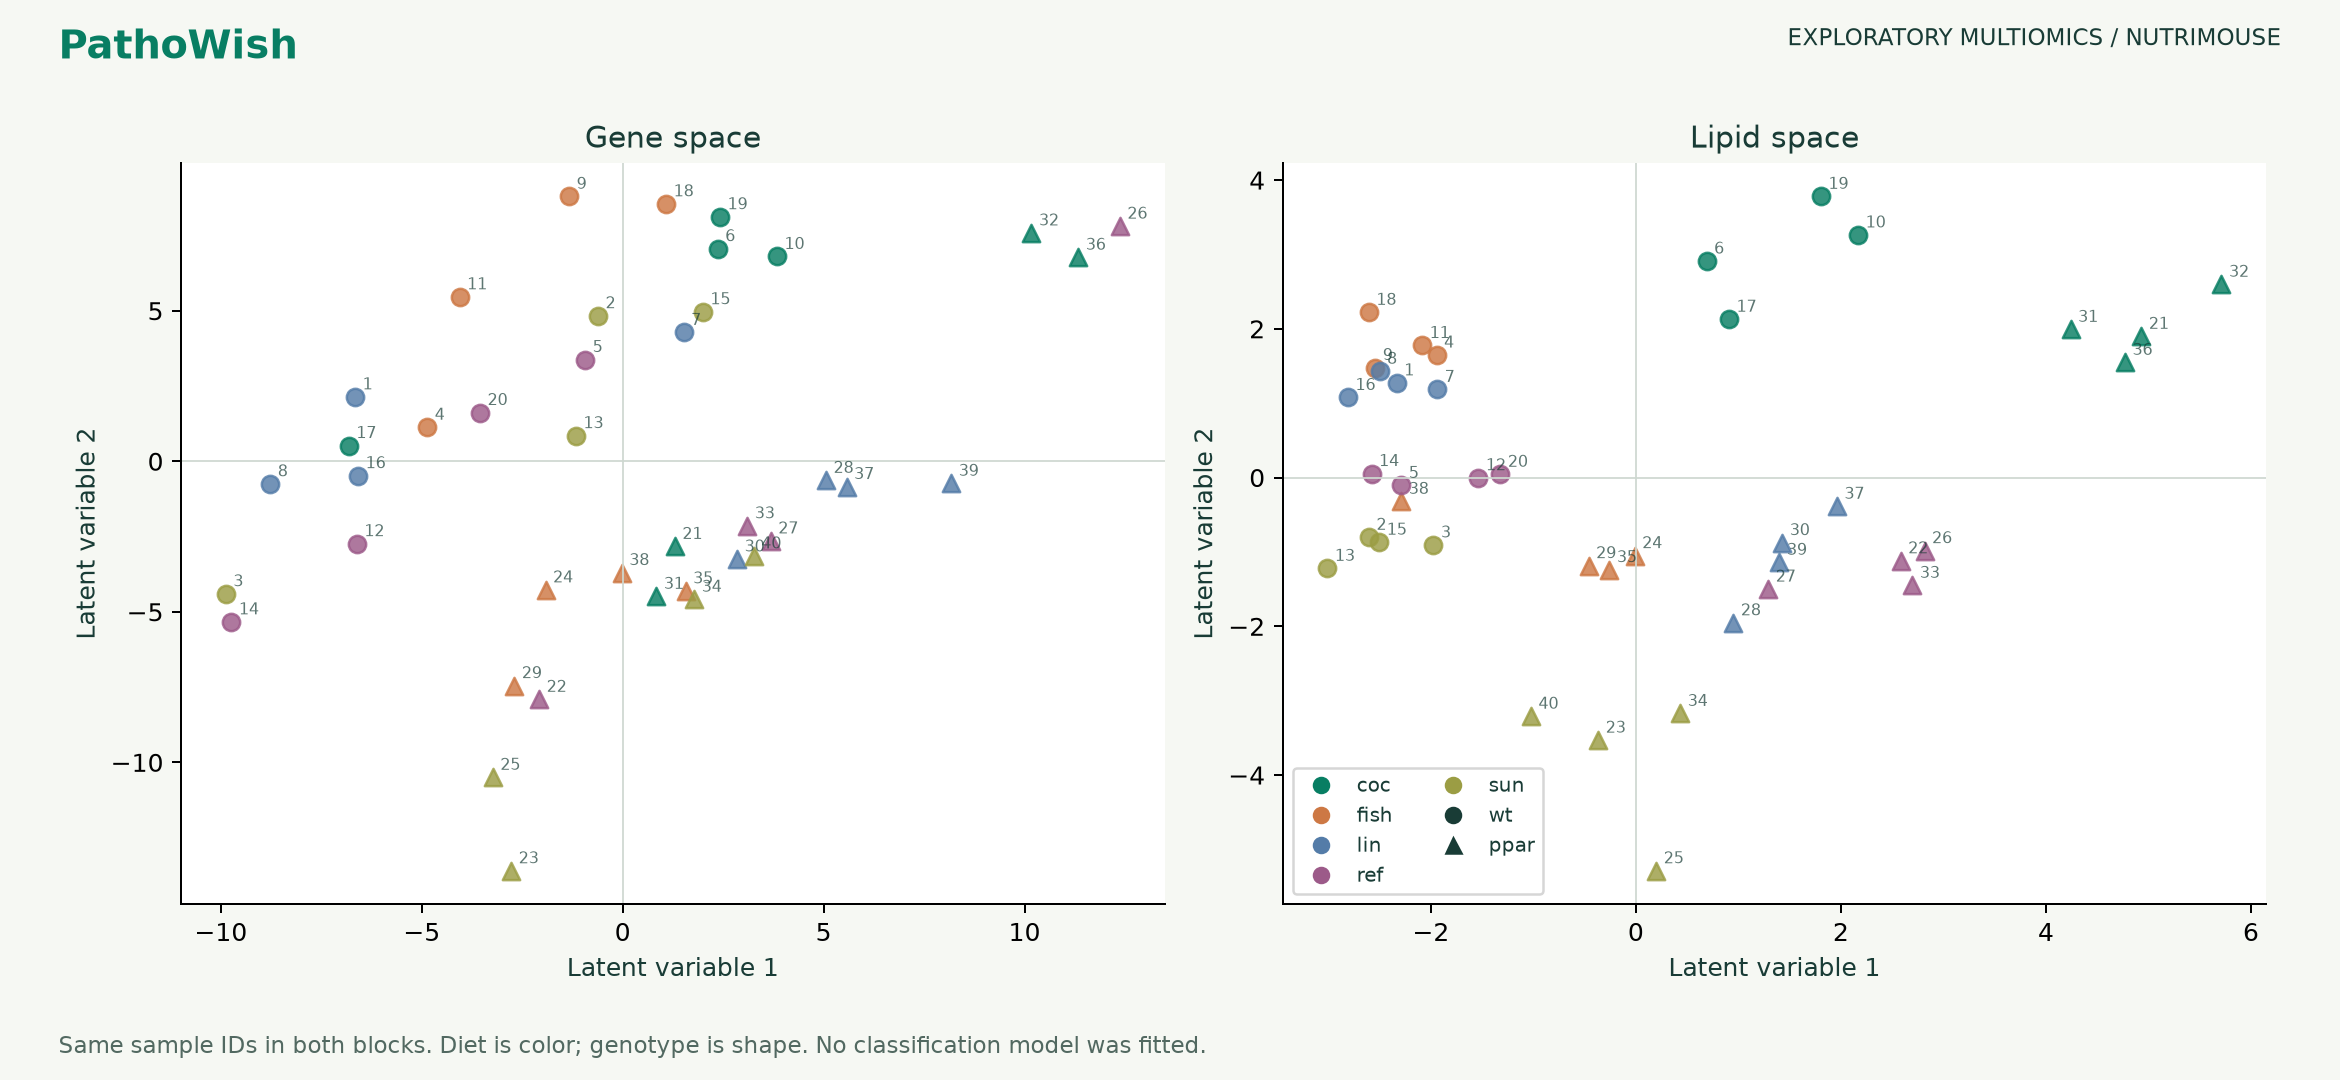
程序按 sample_id 对齐数据,每列减去均值并除以样本标准差(ddof=1)。本次 40 个样本与全部特征均保留,测量值完整。
设标准化后的两块数据为 X、Y,样本数为 n。程序计算 C = XᵀY / (n−1),对 C 做奇异值分解,取前两组权重得到基因和脂质得分。最大绝对基因权重的方向固定为正,使图形方向可重复。
两个成分提供便于阅读的探索视图。饮食与基因型用于标注样本;相关结构的解释同时结合这些分组、批次与脂质组成特点。
5. 阅读投影、载荷与关联热图
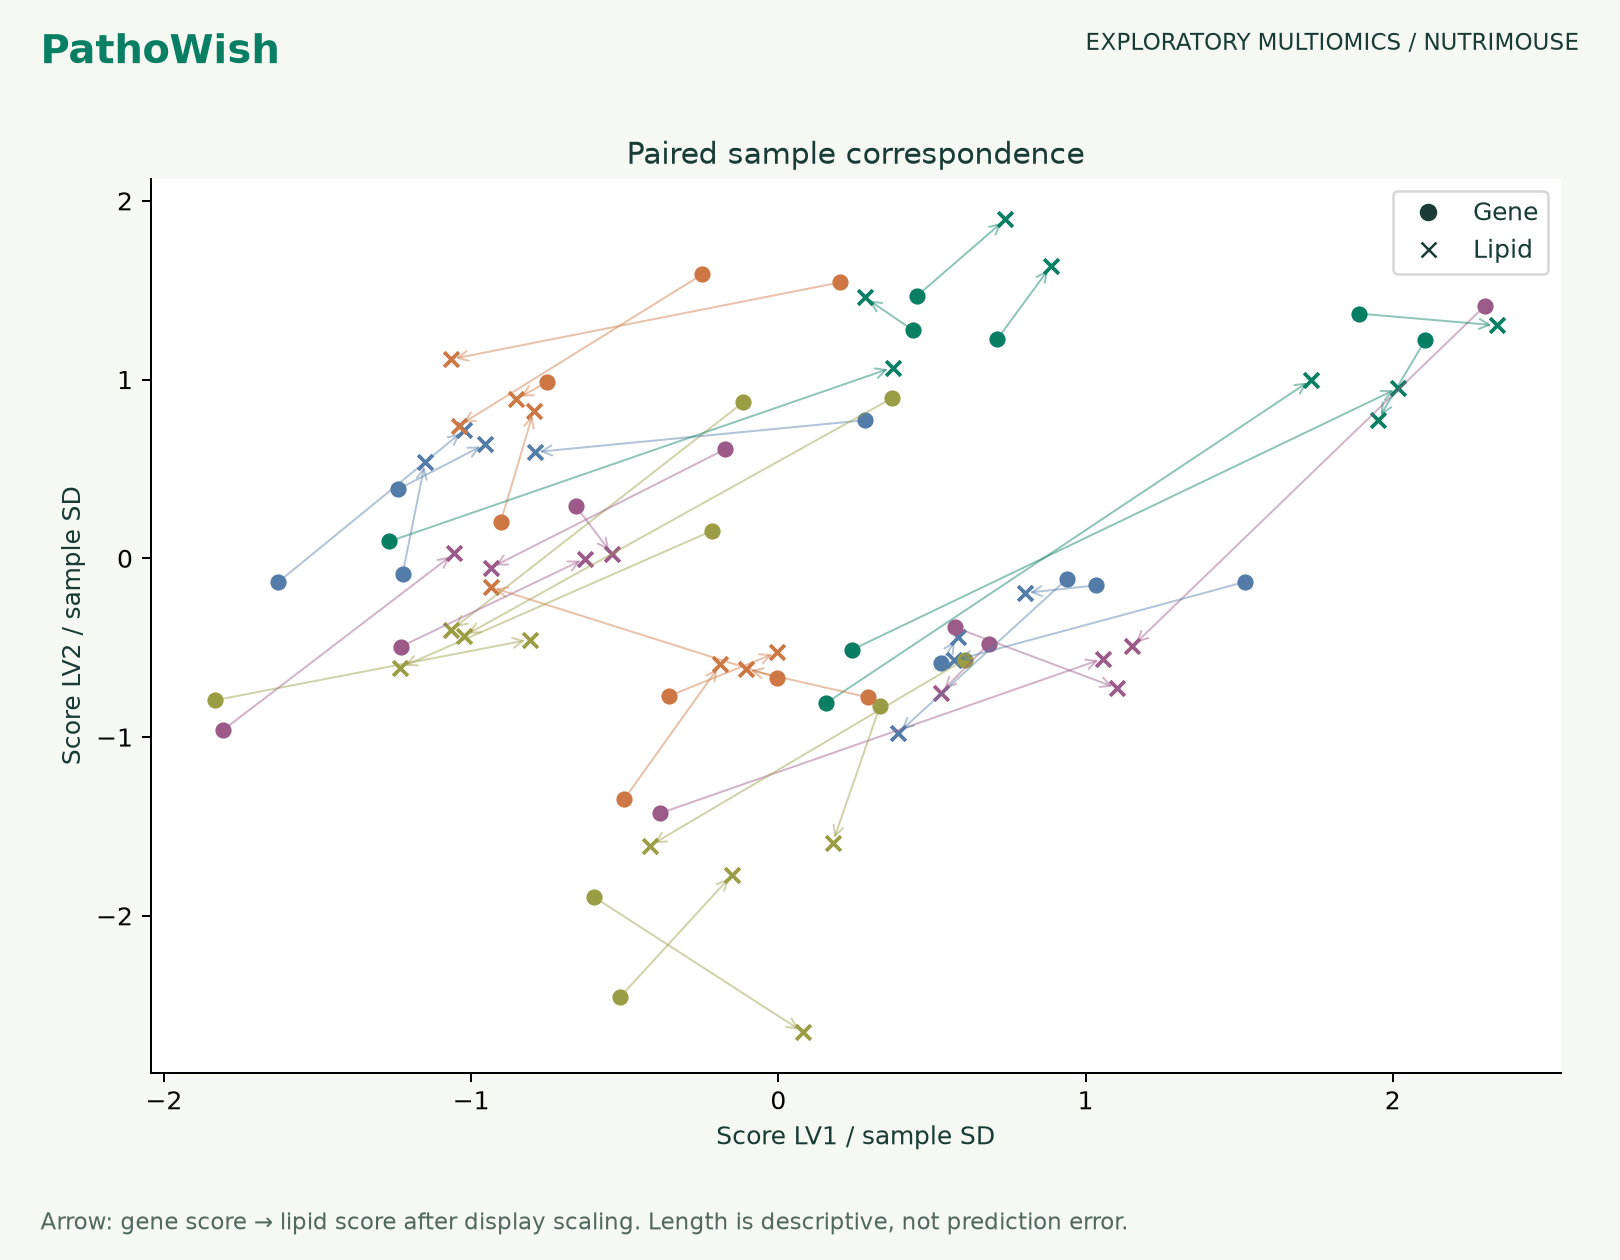
圆点是基因得分,叉号是脂质得分,箭头连接同一只小鼠。为了在同一图中比较,两块坐标分别按得分标准差缩放;完整原始得分保存在 scores.csv。
| 结果 | 本次值 |
|---|---|
| 共同样本数 | 40 |
| 基因 / 脂质特征 | 120 / 21 |
| 第一成分跨块得分相关 | 0.655153 |
| 第二成分跨块得分相关 | 0.686738 |
| 前两成分交叉协方差能量比例 | 79.635674% |
| 数值检查 | 8 项通过 |
“交叉协方差能量比例”按前两项奇异值平方占全部奇异值平方和计算。8 项检查核对中心化、标准差、载荷正交、SVD 重构和跨块协方差,最大误差约为 1.95 × 10⁻¹⁴,满足 10⁻⁹ 容差。
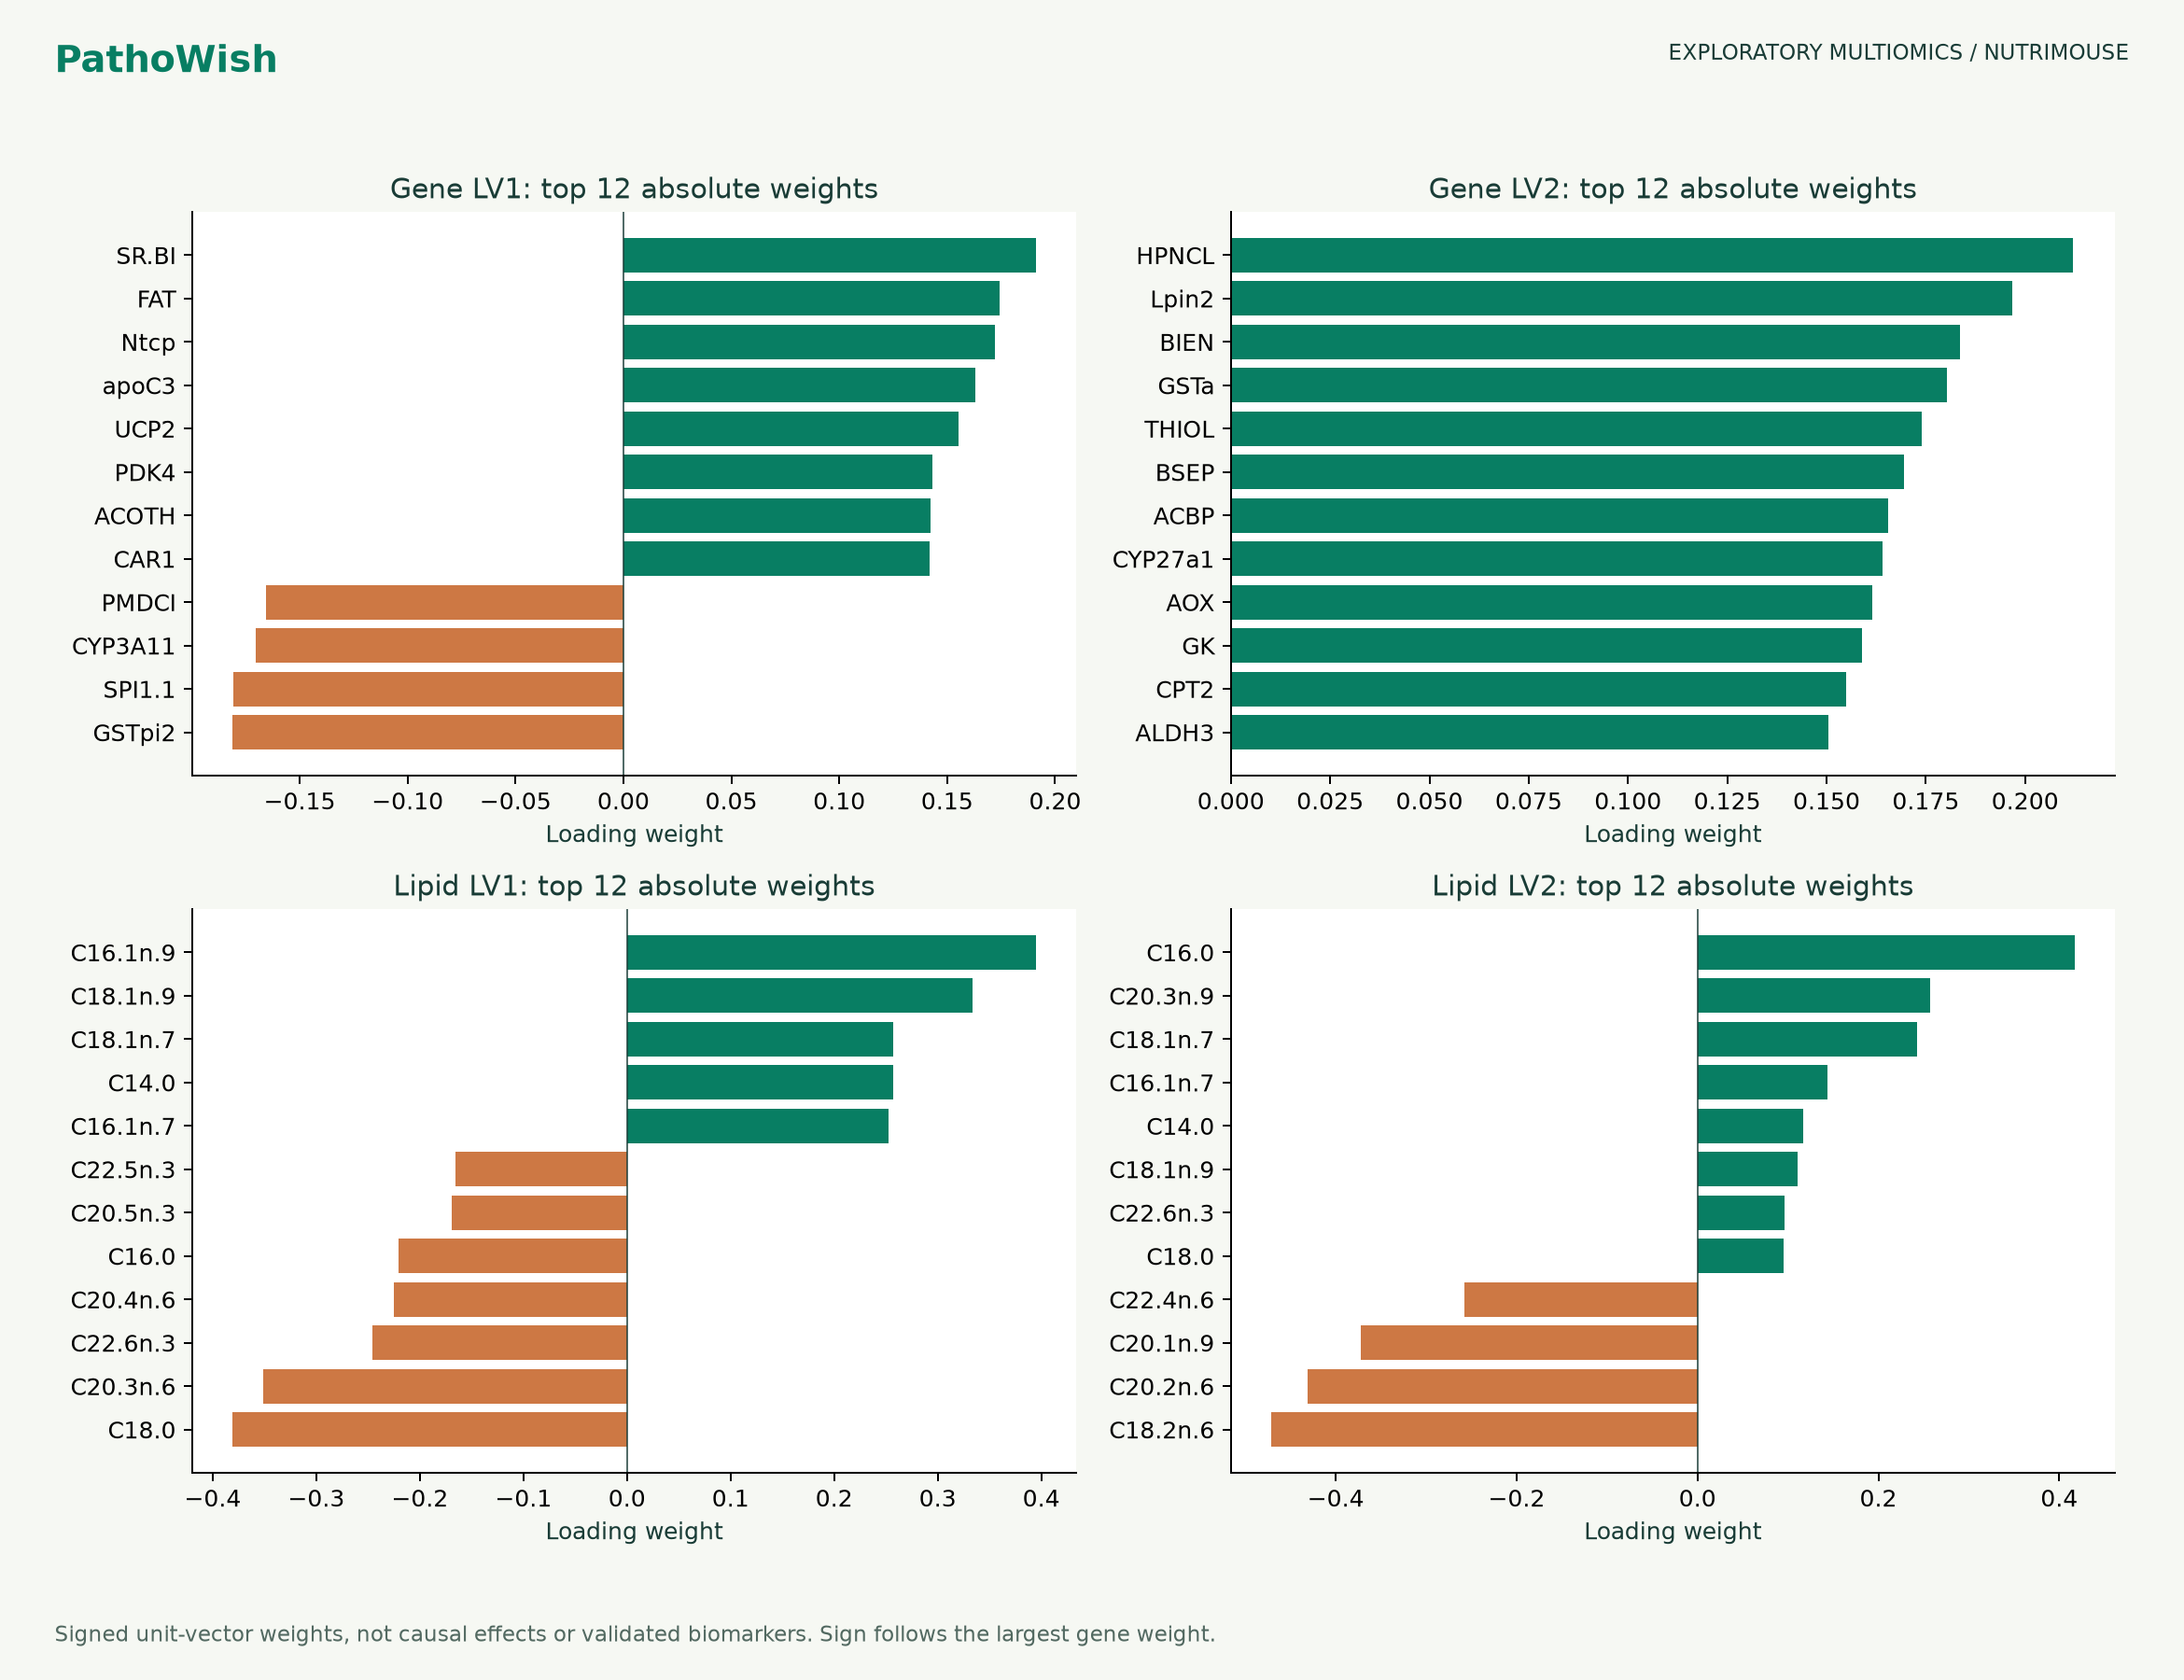
每块数据的每个成分展示绝对值最大的 12 个权重,颜色区分方向。完整载荷表保留全部 120 个基因与 21 种脂质,可用于进一步查看相关变量。
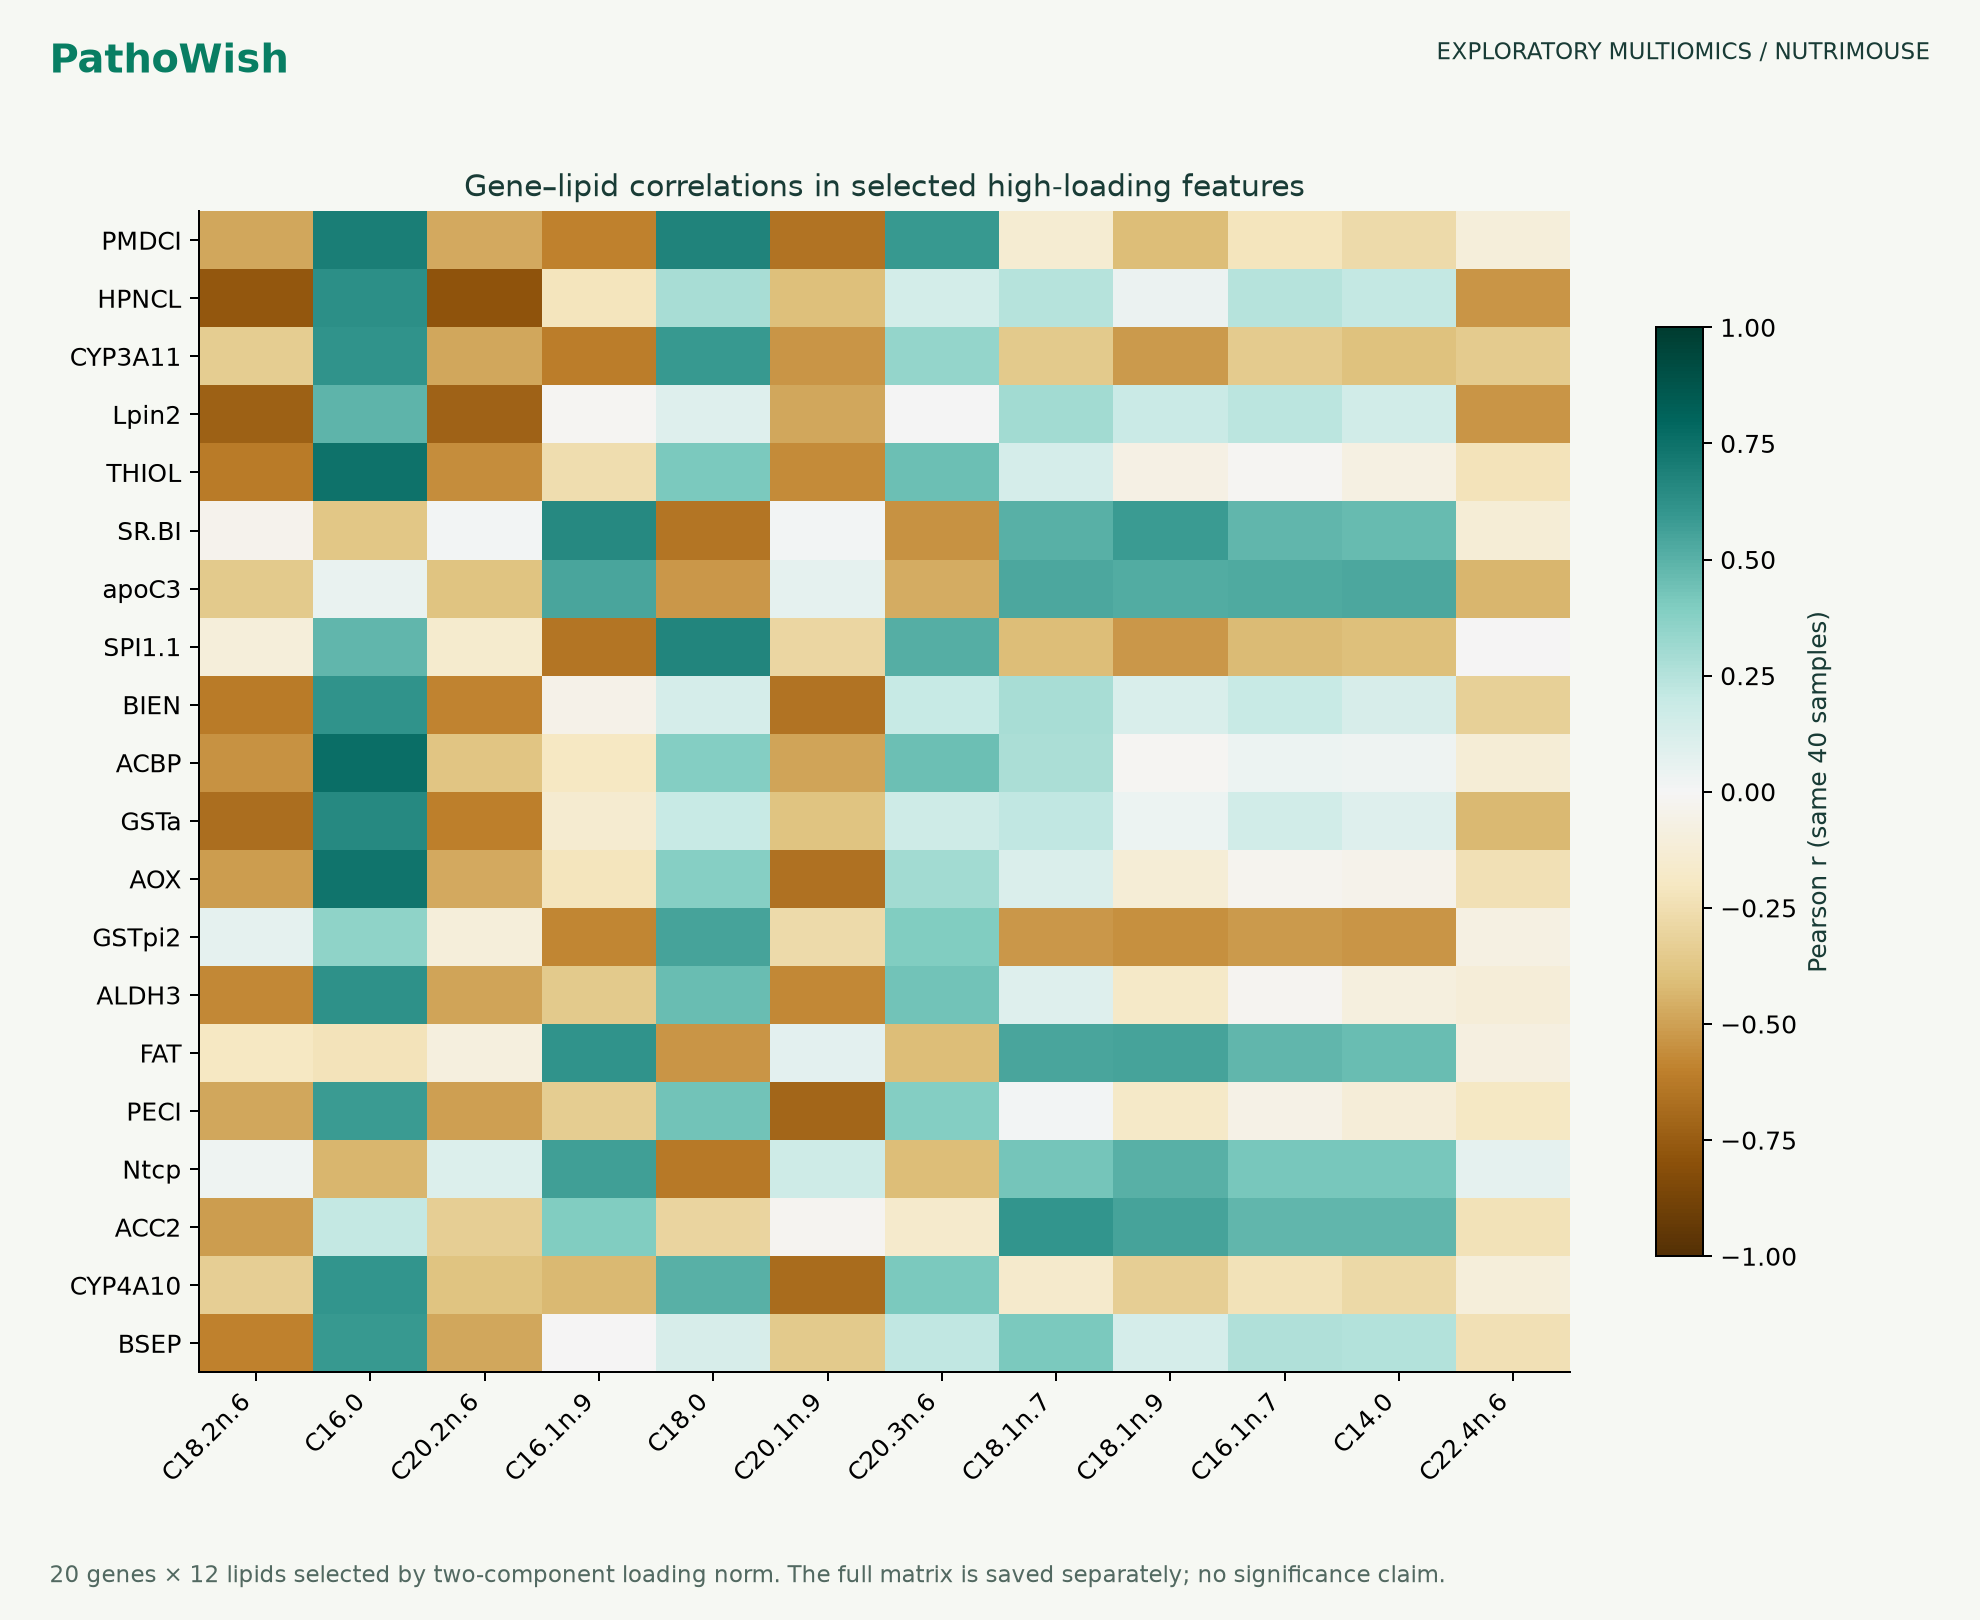
热图根据两成分载荷向量的长度选择 20 个基因和 12 种脂质,颜色表示这 40 只小鼠中的 Pearson 相关。完整的 120 × 21 相关矩阵另行保存,便于自行调整展示范围。
6. 查看报告并扩展分析
进入“结果与图表”阅读汇总报告,点击“打开结果文件夹”查看 21 项计算产物:11 张 CSV、3 份 JSON、2 份 NPZ、4 张 PNG 和一份 Markdown 结果说明。插件同时生成带 PathoWish 标识的 HTML 报告、执行选择记录和分析摘要。
点击“打开项目代码”,可以调整预处理、成分数和图表。METHODS.md 记录计算方法,DEPENDENCIES.md 说明依赖用途与版本。
例如,继续输入:
请保留当前版本,增加第三个成分,并比较前两个与前三个成分的交叉协方差能量比例;同时输出按饮食组着色的前三成分图。
本例用于探索同一样本中两类测量的关联。开展预后或疾病预测时,可在新方案中加入结局变量、训练验证划分和独立评价;原始平台的归一化步骤也应随输入数据一并说明。
数据与方法来源
- 数据:mixOmics Nutrimouse 固定版本,使用时保留来源与许可说明。
- 参考论文:Rohart F, Gautier B, Singh A, Lê Cao K-A. *mixOmics: An R package for ‘omics feature selection and multiple data integration*. PLOS Computational Biology, 2017. DOI: 10.1371/journal.pcbi.1005752。
实验记录:2026 年 10 月 15 日,项目版本 version-3c965cf422e2、运行 run-df67f13a06,prepare、integrate、report 三步完成。PathoWish 实际项目后端执行计算,当前会话模型完成资料阅读、代码生成与结果审阅。